Posts

ECEN4003 个人整合的知识点

ECEN4003 个人整合的知识点 Last Update : 2021年4月29日 - by Mane. 0x0h 编程部分 Python3 基本编程 Python 3 : [ 菜鸟教程 ] Numpy : [ User Guide ] [ API ] Pandas : [ 官网 ] Matplotlib : [ Example ] 熟用 : Numpy 和 Pandas 还有 List 之间的 互相转换 就可以了。 知道 :如何用 Matplotlib 画图,画图的时候再看文档就好了。 Scikit-learn 基本编程 Scikit-learn : [ 官网 ] 要求 :要有自己的想法,会使用 数据 和参考 官方文档 生产出一些程序。 0x1h 建议学习时间 每天半小时,理论这东西挤在一起太多会腻。 注意: 不要背公式!!不要背公式!!不要背公式!! 知道怎么用,是什么就行了,后面好多公式并不要求你推出来,程序人家也给你写好了,你只要会调用就行了!! 0x2h 无监督学习:分类,降维等 个人观点:下面是知识点, 标题是重点 ,连接全都是给个参考的,看不懂自行去 Google 理解吧。 Lecture 2 理论:什么是 有监督学习 与 无监督学习 ( Supervised vs Un-supervised learning) ? 监督学习和无监督学习 Supervised & Unsupervised(贪心学院 Greedy AI)- Youtube 推荐1.25倍速看,看完你会大概知道他们的大致的区别。 有提到一下 Q-Learning : 什么是 Q-Learning - Youtube 用一个非常经典的例子告诉你什么是 Q learning 极简 Qlearning 教程(附 Python 源码)- 知乎 无视代码看图思考,你会发现他的特点是用数组放着权值来进行操作,缺点是如果用来下围棋,这个数组会非常的大,这个时候就可以把数组喂入 NN , DQN 算法就是这样衍生而来。 Lecture 3 - 1 先前知识: 数组 ,去参考PPT上的数组运算就好 理论:聚合算法一, K-means StatQuest: K-means clus...

Esp32 芯片 16MB Flash 的分区表问题

Image
前言 Esp32这块芯片真的好久都没有用了,原因是Flash真的太小了,Esp32最大支持Flash内存大小是16MB(因为设计的时候用的是24Bit的地址),某宝上常见的Esp8266常见的为4MB,16MB的ESP32卖的价格算起来还不如买个pi,4MB的Flash小到真的很操蛋。就比如你调用了几个依赖库,这4MB的大小很快就用完了。当然你也可以使用Web + OTA,但是方案会有个 很大的缺点 。 近期有人拿了一块esp32的衍生物给我做研究: LILYGO 家的 TTGO T-Display (Flash 16MB) 因为这个Esp32芯片的Flash有16MB,但 Arduino IDE 1.8.13 里 Tools 下的 Partition Scheme 还停留在4MB Flash的时代除非你选了ESP32 Dev Module,如果只选择TTGO T1的话,就算是16MB的Flash,经过了Arduino的IDE编译出来的程序Upload上去,用的还是4MB的分区表,至于剩下的12MB内存也就只能空在那里了。所以,回过头来还是没有真正的解决了问题。虽然Flash Size 已经选了 16MB(128Mb),但是分区表依然没有扩大。 可以看到都是4MB的分区大小。 使用esptool检查总共的Flash大小  有些某宝商家故意会误导你,会把 16Mb 的b写成的小写的b,然后拿出来卖,让你以为是真的是16MB。 为了避免这种尴尬的情况,所以开始之前要使用esptool来检查这块芯片到底有没有16MB的Flash。 可以先使用下 flash_id 和 chip_id 参数观察一下,如果不妙的话去可以去售后问下或者退款。 这里以ESP32 标准的4MB作为example: $ python -m esptool --port COM3 flash_id esptool.py v3.0 Serial port COM4 Connecting.... Detecting chip type... ESP32 Chip is ESP32-D0WDQ6 (revision 1) Features: WiFi, BT, Dual Core, 240MHz, VRef calibration in efuse, Coding Scheme ...

TensorFlow 之 Mane 个人用笔记(一)

Image
training_images = training_images / 255.0 test_images = test_images / 255.0 Before you trained, you normalized the data, going from values that were 0-255 to values that were 0-1. What would be the impact of removing that? Why should we normalize data for deep learning in Keras? model = tf.keras.models.Sequential([ #tf.keras.layers.Flatten(), tf.keras.layers.Dense(64, activation=tf.nn.relu), tf.keras.layers.Dense(10, activation=tf.nn.softmax)]) What would happen if you remove the Flatten() layer. Why do you think that's the case? You get an error about the shape of the data. It may seem vague right now, but it reinforces the rule of thumb that the first layer in your network should be the same shape as your data. Right now our data is 28x28 images, and 28 layers of 28 neurons would be infeasible, so it makes more sense to 'flatten' that 28,28 into a 784x1. Instead of wriitng all the code to ...

AI概论 第四周笔记 - AI and Society

Image
前言 这是 AI 概论的最后一篇内容,主要讲的是 AI 和人性方面的问题。禁止转载。 Week 4 Introduction 简单介绍下这篇笔记: AI 存在过度的炒作:AI确实正在改变世界,但现在媒体还存在过度的炒作。为了让普通民众、商业领袖 和政府领导可以快速上升职位,理解 AI 的前景还是相当重要的。 AI 存在局面性:前面几个星期说过,AI还存在一个局面行,并不是100%做得到。其实跟人一样,人也会犯错的,何况AI呢。 种族歧视:AI可能对少数群体或其他团体,存在着不公平的歧视。 高级AI攻击:例如,我们很喜欢使用的垃圾邮件过滤器,因为它使邮件系统能正常工作。但也有些垃圾邮件发送者 正尝试去攻击这些过滤器。即便我们继续开发新的AI技术,但还会受到一些新型攻击。 发展人工智能。 A realistic view of AI AI 对人类社会生活都产生了巨大的影响。我们需要对 AI 有一个客观的认识,不能过于乐观,也不能太悲观。如果你有听说过 金发姑娘和三只熊的故事,你就会知道故事里提到的粥 既不能太热,也不能太冷。故事里的床既不能太硬,也不能太软。 AI 也需要类似的 " 金发姑娘原则 " 因此我认为对于 AI 能够做的事也不能抱有太乐观的希望,当然也不能太过于悲观。 如果对AI技术太乐观而且不顾实际的话,会让人觉得AI是感知智能和超人工智能或强人工智能时代即将到来, 因此,就要投入大量的资源来抵御可怕的AI杀人机器。但是以这种做学术研究的角度来看,研究遥远未来的可能性并没有什么害处。比如研究 AI 哪一天会实现感知智能,这也没有什么害处。我们也不能过度投入资源来抵御一些中长期内都不会出现的风险。可能这几十年、几百年都不会出现,所以我觉得没有必要去害怕超级人工智能或强人工智能。这些不必要的恐惧会让我们分心且不去关注一些真正要解决的问题,也会让社会引起对AI的不必要恐惧。 反过来说,我们也不能对AI太过悲观,认为 AI 什么都做不了。有些事情 AI 不可能完成,所以 AI 的冬眠期将要到来。AI冬眠期是指在 AI 发展的历史中 陆续有几段时期AI被过度炒作,而当人们发现 AI 不能做到一切 人们就对 AI 丧失信心 并减少对 AI 的投资。 如今的 AI 技术 与几十年前冬眠...

AI概论 第三周笔记 - Building AI in Your Company

Image
Week 3 Introduction 在过去的两周里你了学到了什么是人工智能 , 以及如何构建一个人工智能项目,一个公司要想应用人工智能 可能需要两三年的时间,不仅仅只是做过一个人工智能项目,而是一系列有价值的人工智能项目,而且做得很有效率。禁止转载。 这些将是你本周会看到的话题: 复杂的人工智能产品的案例研究:比如一个智能音响 或者一辆自动驾驶汽车。 团队中的主要工作类型:建立一个大型的人工智能团队时, 这也许是好几十人 甚至几百人, 这些人都会做些什么事情。 你也会了解到 人工智能转型手册:学习如何帮助你的公司转型成为擅长应用人工智能的公司。 Case study: Smart speaker 现在来研究一下智能音箱,打造一个复杂的人工智能产品是什么样的感觉呢? 这意味着不仅仅用一个单一的机器学习算法去学习从A到B的映射,为了打造一个复杂的产品,通常都是很多个人工智能结合在一起。 有一天你可能会说 "hi, Mane" ,作为触发词或唤醒词要唤醒一个智能音箱,他的工作原理是什么呢?简单来说我们会划分为4步: 第一步,是探测到触发词或唤醒词:当他们听到了唤醒或者触发词 "hi, Mane" ,NN 就会输出就是0或1 。一旦它听到触发词或唤醒词,听到 "hi, Mane" 时,它还必须接着执行第二步。 第二步,语音识别:也就是说,此时软件要做的是在得到 "hi, Mane" 的音频之后,把你说的话输出成文本。 第三步,用刚输出的文本,判断要交给哪个模块。比如"我要设置10分钟定时器",就把这句话交给定时器去处理。 第四步,模块去执行指令。 Case study: Self-driving car 自动驾驶一直都被称为神秘的技术,现在来一点一点的了解什么是自动驾驶系统。 汽车会接收各种各样的传感器作为输入,比如汽车前方、侧面或后方的图片,以及声波雷达 或激光雷达的传感器读数。有了这些作为输入就能探测出其他车辆的存在或所在位置,这样就可以发现附近有车,同时注意到行人的位置。因为我们想要避开其他车辆以及行人,所以汽车探测和行人探测 都可以通过机器学习来完成,即A --> B的过程,这里的输入可能是图...

AI概论 第二周笔记 - Building AI Projects

前言 续上一个星期的内容, 禁止转载 。 Week 2 Introduction 在这一篇文章中,会介绍启动一个AI项目需要做什么,AI的流程是什么,怎么去选择一个AI项目,如何组织数据和建立团队,无论对你自己或是和朋友一起,亦或是企业里更大规模的队伍,都是重要的。 Workflow of a machine learning project 机器学习可以学习从输入到输出,或 A-->B 的过程。 第一步是收集数据:现在那语音助手举个例子,比如苹果的siri,你得到处走然后让人们来说这个词'siri' ,然后你把这些语音记录下来,同时也需要收集其他的词 例如'你好'等很多其他的词,并且录音下来。当你收集了非常多音频数据 也就是收集了很多不同人说 'siri' 或其他词语的语音后就可以开始训练数据了。 第二步就是训练模型,就是说你需要利用一个机器学习算法 来学习从输入到输出,或者是A到B的映射,这里输入A就是一段上面收集的语音。这个时候团队会尝试第一次建立模型和训练,如果一次尝试的效果不好就需要尝试很多次。(在人工智能领域,叫做反复迭代。)直到模型看起来足够好为止。 第三步就是把训练好的模型发放给任何人用,让任何人去评估这个训练好的模型。如果有人觉得不好用,或者有人说siri之后 NN 没反应,这个时候就要维护和更新下 NN (比如英式口音和美式口音)。 Workflow of a data science project 和机器学习项目不同,可以从数据科学那里得到改进的行动和观点。这些观点可能会让你的采取不同的行动,所以数据科学项目与机器学习的工作流程不同。 如果你在运营一个卖咖啡杯的电子商务平台 或者是在线购物网站,所以当一个用户从你这购买咖啡杯时,他们常常需要经过一系列步骤。 首先,他们将访问你的网站,浏览不同的马克杯,然后他们点进某个产品的详情页面,他们把商品放入购物车,进入支付界面,最终他们将支付订单。在这个过程中可以通过用户点击记录一份日志。 第2步是分析数据,你的数据团队可能会想出很多会影响销售因素,例如,数据团队也许 会认为海外顾客因为国际运费太高而被吓退,这可以解释为什么很多人虽然 点进了支付页面,但是最终没有下单。如果真是这样,那么你可能会考虑是否把部分运...

AI概论 第一周笔记 - What is AI ?

Image
前言 年纪轻轻的,学 AI 不怕掉头发吗?以下是本喵整理的笔记, 禁止转载 。 另外个人觉得现阶段 AI 和 NN 没有什么区别,所以下面的 AI 和 NN 是互相对等的。 Week 1 Introduction 总结来讲,AI 实际上是两个独立的概念: 弱人工智能 :几乎所有我们可以看到的人工智能中的进展都是弱人工智能,这些的AI只会做一件事情,比如智能音箱或者自动驾驶等。这类的AI只有单方面的成果。 强人工智能 :他们可以做人类可以做的事情,甚至可能能够做人类都不能够做的事情。 不过现阶段来说弱人工智能在进步,几乎没有强人工智能的方面。两个方面都有价值,但很不幸的是由于弱人工智能的快速发展,导致人们认为整体的人工智能有很大的进步,但也会导致一些非理性的恐惧,让人以为 AI 会取代人类。 现阶段强人工智能的确是一个很厉害的目标,但还要更多的科研,他需要多方面的技术才可以实现,这意味着未来十几年或者几百年甚至几千年的探索才可以突破。正因为强人工智能离我们太远,所以也没有必要太过于担心这件事。 Machine Learning 最常用的机器学习模型实际上就是学习 A --> B 的过程,这个叫监督学习。 为什么AI现在才开始崛起呢?其实原因很简单,以前的计算机有很大的限制,比如硬盘太小等等,随着时间变化,计算机和网络大量的普及,时间越久收集到的数据就越多。AI则是使用这些数据来训练,数据越多AI就越准。当 NN 越大的时候,结果就越精准,但需要的数据也就越多,这就是为什么经常听到 大数据 。 What is data? 到底什么是数据?简单来说就是放进去NN的那堆数据。 数据从哪来? 手动标记:假设你拿到了一堆猫猫狗狗的图片,你想要让 NN 区分猫猫狗狗,你就可以对这些图片进行描述,然后喂入 NN 。 从采集器那边获取:比如做一个 APP 当用户点 Yes or No 的时候采集器就可以开始收集数据啦。 下载开源的数据:比如  TensorFlow 自带的模块 有很多开源的数据。 另外,一些软件团队会经常错误的收集错误,这个时候就要和 AI团队 去沟通,要使用AI做什么,有没有价值等等,但也不要错误的认为把数据交给 AI团队 就一定挖掘到价值。 其次是数据是非常乱的,如果你提供的...

TensorFlow 官方自然语言处理系列 笔记

Image
前言 个人整理的笔记,如有错误可以评论区更正下喵,毕竟本喵正在学习,强烈建议在看这篇文章之前先去看看官方视频。 视频 TensorFlow 官方自然语言处理系列视频  (英文字幕,约40分钟) Natural Language Processing - Tokenization (NLP Zero to Hero - Part 1) 有些人使用每一个单词里面的字母换成 ASCII 码然后扔进去 NN 处理,但是对于 NN 来说,得到了一堆只是相同的但顺序不同的 ASCII 码,这样 NN 很难理解一个词的感情,所以这个时候,需要把一个单词变成编号即可。 [Colab] from tensorflow.keras.preprocessing.text import Tokenizer sentences = [ 'i love my dog', 'I, love my cat', 'You love my dog!' ] tokenizer = Tokenizer(num_words = 100) tokenizer.fit_on_texts(sentences) word_index = tokenizer.word_index print(word_index) 运行后的结果 {'love': 1, 'my': 2, 'i': 3, 'dog': 4, 'cat': 5, 'you': 6} 当然还可以输出 word_docs 和  word_counts 。 那么问题来了,为什么 dog 和 dog! 元素是一样的呢?其实在处理的过程中,Tokenizer 会很智能的把每一个大小写或者标题符号给转换或者省略掉,当然 loves 和 love 也看成是一样的。 参考 Keras分词器 Tokenizer Sequencing - Turning sentences into data (NLP Zero to Hero - Part 2) 当统计好单词以后,怎么把句子变为一串编码呢?其实只需要插入多一句就可以让句子变成编码了。 [Colab] ...

安卓adb模拟输入太慢的几个解决方法

Image
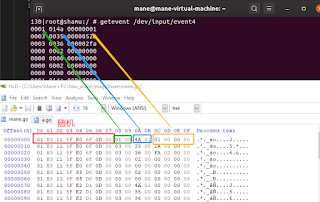
前言 起初通过了adb shell input 来控制安卓的输入的时候,发现 adb shell input 非常慢,网上说 adb input 输入时要对本地进行 I/O 处理,通过 getevent 发现 adb 并没有对 event 进行操作。在这里我使用我之前写的 python自动玩连连看 来举个栗子,下面这个栗子使用的是夜神模拟器,Android 5。 注意 这篇讲如何使用 adb ,必须要对手机进行 root ,推荐使用安卓模拟器来实验。 问题 如果单纯的用 Python 进行控制 adb 的话,只用 adb 速度几乎一秒钟点击一次。 Python 伪代码: [Github] def run_list(setp_list): ... for setps in setp_list: for y,x in setps: tx = 131 + (x-1) * 74 ty = 146 + (y-1) * 91 subprocess.call("adb shell input tap " + str(tx) + " " + str(ty) , shell=True) 在这个情况下,对一些游戏场景还是不友好,比如玩连连看,到底要点到什么时候呢? 改进一:sendevent 在 Linux 中,有一个 /dev/input/ 的目录,里面的有各种 event ,这些 event 所触发的事件都是来自外部的各个输入设备,在 /proc/bus/input/devices 可以看到当前系统的各个输入设备。 [Github] root@shamu:/ # cat /proc/bus/input/devices ... I: Bus=0000 Vendor=1234 Product=0001 Version=0001 N: Name="Android_Input" // 安卓输入事件 P: Phys= S: Sysfs=/devices/virtual/input/input4 U: Uniq= H: Handlers=sysrq r...

常用的图片相似度比较算法 目录引文

前言 对比两张图片的相似度,用来干啥大家都知道。 常用几种的算法 差异比较法:两张图片相加减,最后得到一个百分比。 How do I calculate the percentage of difference between two images using Python and OpenCV? 直方图统计:通过计算三种颜色的直方图,或者只计算一个颜色的直方图来做对比。   (什么是直方图?) Python-Opencv中用compareHist函数进行直方图比较进行对比图片 OpenCV Histogram Comparison [CN] 哈希算法:找图片特征码进行对比。 图像相似度中的Hash算法 python OpenCV 图片相似度 5种算法 TESTING DIFFERENT IMAGE HASH FUNCTIONS How to check similarity of two images that have different pixelization MSE & SSIM:通过每个像素的方差做对比。 Python计算两张图片的相似度 How to calculate the Structural Similarity Index (SSIM) between two images with Python 关键特征提取和匹配: 图像处理之特征提取 SIFT、SURF、ORB、HOG、LBP、HAAR特征的原理概述及OpenCV代码实现 python opencv3 基于ORB的特征检测和 BF暴力匹配 knn匹配 flann匹配 【python 图像相似度】OpenCV图像相似度ORB算法--相似图像去重 OpenCV-Python Feature2D 特征点检测(含SIFT/SURF/ORB/KAZE/FAST/BRISK/AKAZE) 综合: python图像识别---------图片相似度计算 Python计算图片之间的相似度 还有的谷歌找去吧

Haproxy 对 socks 做负荷均衡 带配置文件

前言 海外的用户如果要使用国内进行看剧可以去找免费的socks代理,可以利用Haproxy可以做到负荷均衡。 缺点 只能在Linux环境下使用,Proxychains 也可以做到负荷均衡,但是效果略渣。 Windows 用户可以考虑开一个VM进行流量传输 安装 sudo apt install haproxy 配置文件  /etc/haproxy/haproxy.cfg 模式 对于上面的情况 Haproxy 有两大 负荷均衡 模式: roundrobin -- 表示简单的轮询,每个服务器根据权重轮流使用,在服务器的处理时间平均分配的情况下这是最流畅和公平的算法。该算法是动态的, 对于实例启动慢的服务器权重会在运行中调整 。 leastconn -- 连接数最少的服务器优先接收连接。 leastconn建议用于长会话服务,例如LDAP、SQL、TSE等,而不适合短会话协议。如HTTP.该算法是动态的,对于实例启动慢的服务器权重会在运行中调整。 但免费的SOCKS的代理 连接数是有限制的 ,比如一个代理只能由10个连接数,这个时候就可以用  leastconn 模式进行弥补了,如果遇到好的代理则可以考虑一下  roundrobin 模式 。 找免费代理 谷歌搜索免费代理,复制粘贴,用工具去验证。 工具 免费版的 Socks Proxy Checker Google 搜索 socks checker github 配置文件 [Github] global log /dev/log local0 log /dev/log local1 notice user root group root daemon //守护模式启动 defaults log global mode tcp timeout connect 5s //客户端和后端服务器建立连接的超时时间 timeout client 5s //与客户端的最长空闲时间 timeout server 5s //后端服务器到客户端的超时时间 timeout check 3s //对后端服务器的检测超时...

V2ray 纯 Vmess 的 Socks 前置代理 配置文件

注意 !! 这个配置不适用于 tsl+ws+web,如果你要配置 tsl+ws+web 你可以参考 这篇文章   !! 前言 某些情况下需要让V2ray来走前置代理以便提高速度,或者需要走socks代理。 大概的流程图 Application <---> V2ray Client <--> Socks Server <--> V2ray Server 配置文件 [ Github] { "inbounds": [ { "port": 10808, // Local Listen Port "protocol": "socks", "sniffing": { "enabled": true, "destOverride": ["http", "tls"] }, "settings": { "auth": "noauth" } } ], "outbounds": [ { "protocol": "vmess", "settings": { "vnext": [ { "address": "V2RAY SERVER", "port": V2RAY SERVER PORT, "users": [ { "alterId": 64, "id": "aaaa-bbbb-cccc-d...

安装及使用 laravel 踩到的坑

使用 Ubuntu 系统 php7.4以上 安装的时候改阿里源会比较快,另外安装 Mysql 8.0 在 Ubuntu 19.10 系统里面需要修改源(改成 bionic )。 1. composer.phar 获取 laravel 前需要安装环境 $ sudo apt-get -y install php-mbstring php-xml 2. Mysql Driver 找不到 $ sudo apt-get install php7.4-mysql root@mane-virtual-machine:/home/mane# php -i | grep PDO PDO PDO support => enabled PDO drivers => mysql PDO Driver for MySQL => enabled 有enabled就好了。 3. Laravel 提示 SQLSTATE[HY000] [2054] The server requested authentication method unknown to the client 参考: 这篇文章 4. Access denied for user 'homestead'@'localhost' (using password: YES) 明明.env环境有指定用户名是root $ php artisan config:clear

Allwinner H2+ Sysbench CPU Test (1)

这一篇是关于手上的 全志H2+ CPU 的个人测试结果,仅此参考而已! 对了,裸机,没有任何散热芯片。 首先,看 Linux 上的平台数据: $ lscpu Architecture: armv7l Byte Order: Little Endian CPU(s): 4 On-line CPU(s) list: 0-3 Thread(s) per core: 1 Core(s) per socket: 4 Socket(s): 1 Model name: ARMv7 Processor rev 5 (v7l) CPU max MHz: 1008.0000 CPU min MHz: 480.0000 $ cat /proc/cpuinfo processor : 0 model name : ARMv7 Processor rev 5 (v7l) BogoMIPS : 48.00 Features : half thumb fastmult vfp edsp neon vfpv3 tls vfpv4 idiva idivt vfpd32 lpae evtstrm CPU implementer : 0x41 CPU architecture: 7 CPU variant : 0x0 CPU part : 0xc07 CPU revision : 5 processor : 1 model name : ARMv7 Processor rev 5 (v7l) BogoMIPS : 48.00 Features : half thumb fastmult vfp edsp neon vfpv3 tls vfpv4 idiva idivt vfpd32 lpae evtstrm CPU implementer : 0x41 CPU architecture: 7 CPU variant : 0x0 CPU part : 0xc07 CPU rev...